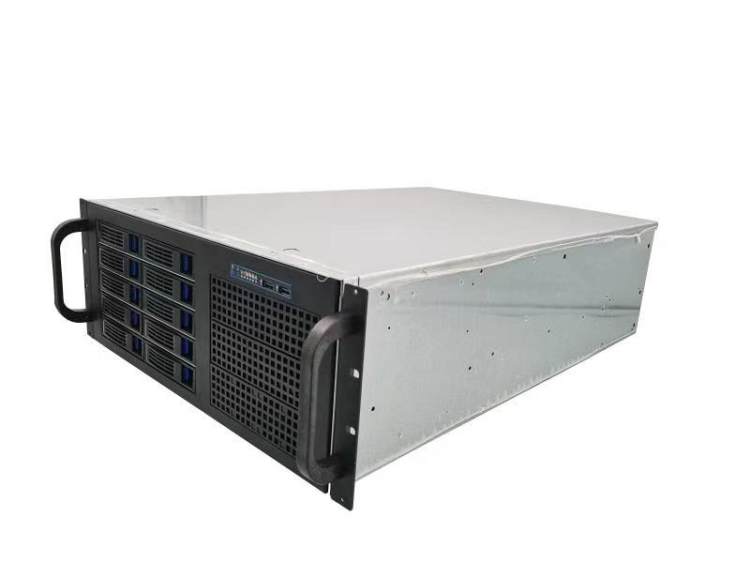
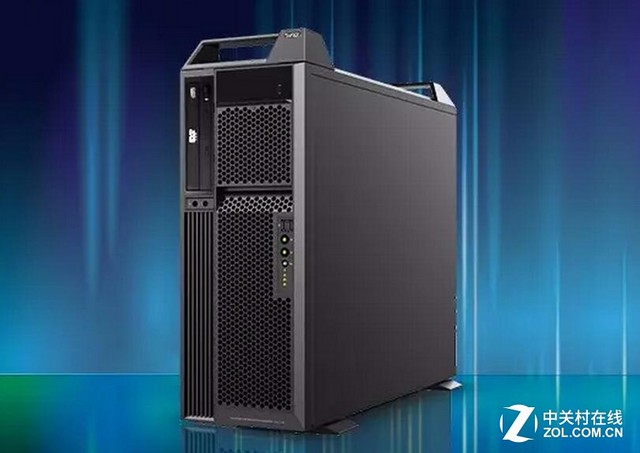
至強(qiáng)多卡GPU服務(wù)器 驅(qū)動(dòng)深度學(xué)習(xí)與AI未來(lái)的4U工作站
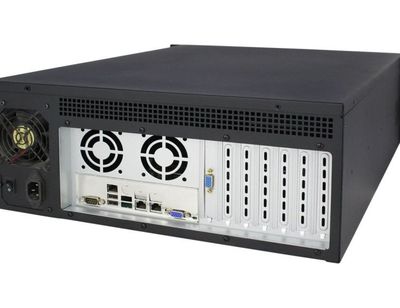
在人工智能與深度學(xué)習(xí)迅猛發(fā)展的今天,強(qiáng)大的計(jì)算力是推動(dòng)前沿研究與產(chǎn)業(yè)落地的核心引擎。至強(qiáng)多卡GPU服務(wù)器,尤其是經(jīng)典的4U機(jī)架式工作站,憑借其卓越的性能、出色的擴(kuò)展性與穩(wěn)定的可靠性,已成為高校實(shí)驗(yàn)室、科研機(jī)構(gòu)及企業(yè)研發(fā)部門(mén)的標(biāo)配,是構(gòu)建AI算力基礎(chǔ)設(shè)施的堅(jiān)實(shí)基石。
一、 硬件基石:性能與擴(kuò)展的完美平衡
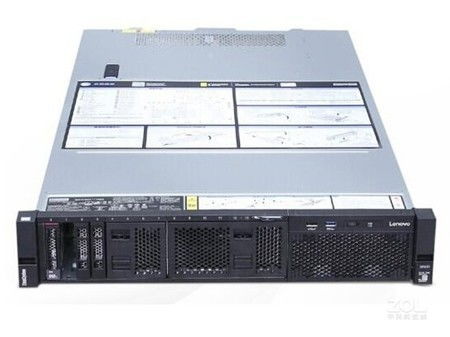
一臺(tái)頂級(jí)的4U深度學(xué)習(xí)工作站,其強(qiáng)大始于硬件架構(gòu)的精妙設(shè)計(jì)。
- 強(qiáng)勁的“大腦”——英特爾至強(qiáng)可擴(kuò)展處理器:搭載一顆或多顆高性能英特爾至強(qiáng)(Xeon)可擴(kuò)展處理器(如最新的至強(qiáng)鉑金系列),提供海量的核心與線程數(shù),以及巨大的內(nèi)存帶寬。這不僅為大規(guī)模數(shù)據(jù)預(yù)處理、復(fù)雜模型邏輯運(yùn)算提供了保障,更能高效管理多塊高性能GPU,消除系統(tǒng)瓶頸,確保算力充分釋放。
- 澎湃的“算力核心”——多卡高性能GPU:4U的充裕空間允許部署多塊(通常4-8塊,甚至更多)頂級(jí)計(jì)算卡,如NVIDIA A100、H100或消費(fèi)級(jí)的RTX 4090等。這些GPU搭載數(shù)以萬(wàn)計(jì)的CUDA核心和專用Tensor Core,專為并行浮點(diǎn)運(yùn)算與矩陣計(jì)算優(yōu)化,是訓(xùn)練百億、千億參數(shù)大模型和進(jìn)行高精度推理的絕對(duì)主力。支持NVLink高速互聯(lián)技術(shù),能實(shí)現(xiàn)GPU間超低延遲、高帶寬的數(shù)據(jù)交換,極大提升多卡協(xié)同效率。
- 海量的“記憶庫(kù)”——高速大容量?jī)?nèi)存與存儲(chǔ):配備高達(dá)數(shù)TB的ECC注冊(cè)式內(nèi)存,確保在加載超大規(guī)模數(shù)據(jù)集和模型時(shí)穩(wěn)定流暢。存儲(chǔ)方面,通常采用NVMe SSD組成RAID陣列作為高速緩存和系統(tǒng)盤(pán),搭配大容量SATA/SAS HDD或更多SSD作為數(shù)據(jù)倉(cāng)庫(kù),實(shí)現(xiàn)從數(shù)據(jù)載入到模型保存的全流程高速化。
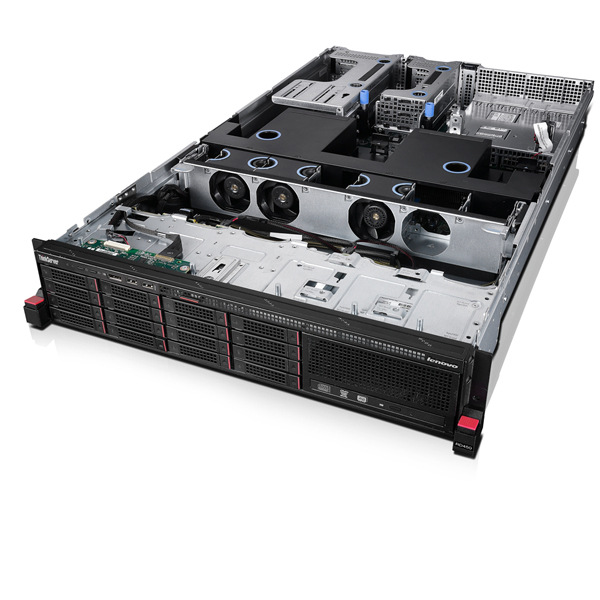
- 高效的“循環(huán)系統(tǒng)”——散熱與電源:強(qiáng)大的硬件必然產(chǎn)生巨大熱量。4U服務(wù)器工作站采用優(yōu)化的風(fēng)道設(shè)計(jì)和高性能冗余散熱系統(tǒng),確保在滿負(fù)荷運(yùn)行時(shí)核心部件溫度可控。80 Plus鉑金或鈦金級(jí)冗余電源則為整個(gè)系統(tǒng)提供持續(xù)、純凈、穩(wěn)定的電力供應(yīng),保障7x24小時(shí)不間斷運(yùn)行的可靠性。
二、 核心應(yīng)用場(chǎng)景:從研究到落地的全棧賦能
這類工作站并非簡(jiǎn)單的硬件堆砌,而是針對(duì)特定高強(qiáng)度計(jì)算場(chǎng)景的深度優(yōu)化。
- 大規(guī)模深度學(xué)習(xí)模型訓(xùn)練:無(wú)論是計(jì)算機(jī)視覺(jué)(CV)中的目標(biāo)檢測(cè)與圖像生成,自然語(yǔ)言處理(NLP)中的大語(yǔ)言模型預(yù)訓(xùn)練與微調(diào),還是科學(xué)計(jì)算中的分子動(dòng)力學(xué)模擬,都需要迭代海量數(shù)據(jù)、調(diào)整數(shù)以億計(jì)的參數(shù)。多卡GPU服務(wù)器提供的并行計(jì)算能力,能將訓(xùn)練時(shí)間從天級(jí)縮短到小時(shí)級(jí),加速研發(fā)周期。
- 復(fù)雜AI推理與部署測(cè)試:在將訓(xùn)練好的模型部署到生產(chǎn)環(huán)境(如邊緣設(shè)備、云服務(wù)器)之前,需要在與生產(chǎn)環(huán)境近似的硬件上進(jìn)行嚴(yán)格的性能測(cè)試、優(yōu)化和壓力測(cè)試。4U工作站可以模擬多路并發(fā)推理場(chǎng)景,驗(yàn)證模型的吞吐量、延遲和準(zhǔn)確性,是產(chǎn)品化前的關(guān)鍵一環(huán)。
- 高性能計(jì)算(HPC)與仿真:在金融工程、氣候預(yù)測(cè)、流體力學(xué)、基因測(cè)序等傳統(tǒng)HPC領(lǐng)域,GPU加速計(jì)算也已普及。多卡服務(wù)器能夠高效處理這些領(lǐng)域的并行計(jì)算任務(wù),提供遠(yuǎn)超傳統(tǒng)CPU集群的能效比。
- 研究與教學(xué)平臺(tái):為高校和研究所提供穩(wěn)定、共享的高性能計(jì)算平臺(tái),支持多名研究者同時(shí)進(jìn)行不同項(xiàng)目的實(shí)驗(yàn),降低單人使用門(mén)檻,促進(jìn)學(xué)術(shù)創(chuàng)新。
三、 選擇與部署考量
在構(gòu)建或選購(gòu)這樣一臺(tái)AI主機(jī)時(shí),需綜合考量:
- 任務(wù)導(dǎo)向:明確主要負(fù)載是訓(xùn)練還是推理,模型規(guī)模和數(shù)據(jù)量大小,以決定GPU型號(hào)、數(shù)量及內(nèi)存容量。
- 擴(kuò)展與互聯(lián):關(guān)注主板PCIe通道數(shù)、帶寬(如PCIe 4.0/5.0)以及是否支持GPU間高速互聯(lián)(NVLink),這直接影響多卡效率。
- 軟件與生態(tài)兼容性:確保硬件與主流的深度學(xué)習(xí)框架(如TensorFlow, PyTorch)、CUDA工具鏈以及容器化部署方案(如Docker, Kubernetes)完全兼容。
- 運(yùn)維與成本:評(píng)估電力消耗、散熱需求、機(jī)房環(huán)境以及總體擁有成本(TCO)。4U服務(wù)器雖然性能強(qiáng)大,但也需要專業(yè)的運(yùn)維管理。
###
至強(qiáng)多卡GPU服務(wù)器工作站,以其模塊化、高密度的4U形態(tài),集成了當(dāng)前最先進(jìn)的通用計(jì)算與加速計(jì)算技術(shù)。它不僅是實(shí)驗(yàn)室中攻克AI難題的“超級(jí)大腦”,也是產(chǎn)業(yè)界實(shí)現(xiàn)AI賦能的核心裝備。隨著算法模型的不斷進(jìn)化,對(duì)算力的渴求永無(wú)止境,這類高性能工作站將繼續(xù)作為基礎(chǔ)設(shè)施的關(guān)鍵組成部分,持續(xù)推動(dòng)人工智能技術(shù)向更深、更廣的領(lǐng)域邁進(jìn),塑造智能化未來(lái)。
如若轉(zhuǎn)載,請(qǐng)注明出處:http://m.fcsmw.cn/product/16.html
更新時(shí)間:2026-10-22 16:22:19